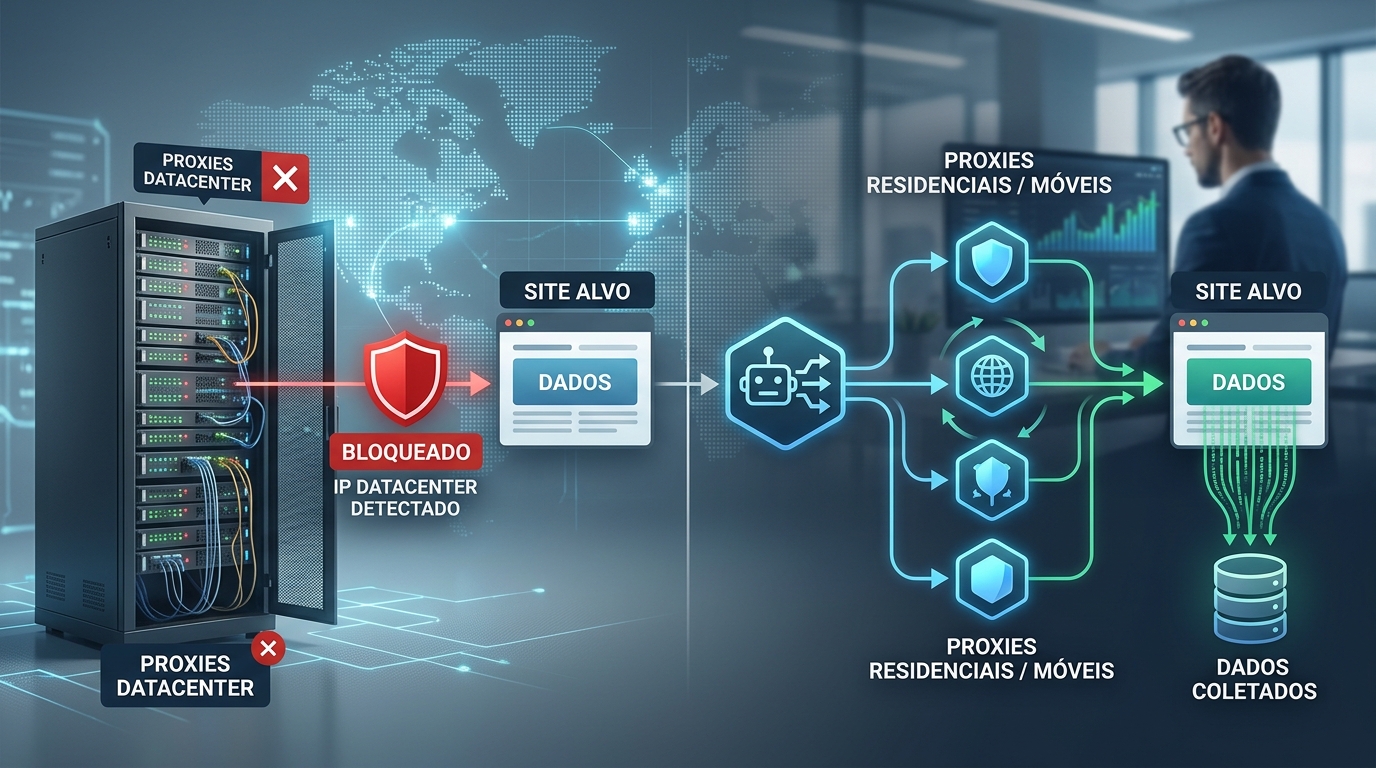
Proxy para web scraping: por que datacenter é bloqueado e o que fazer
Se você mantém um coletor de dados públicos — preços, disponibilidade, conteúdo indexável — provavelmente já viu a taxa de sucesso cair do nada. Não porque seu código mudou. Porque o site do outro lado atualizou a heurística de bloqueio, e ela quase sempre começa pelo mesmo alvo: range de IP de datacenter.
O scraping legítimo também é bloqueado
Há uma confusão comum: bloqueio de datacenter não distingue bot malicioso de coletor respeitoso. Um scraper que respeita robots.txt, limita taxa de requisição e não sobrecarrega servidor ainda é bloqueado se sair de IP de nuvem — porque a heurística olha a origem do tráfego, não o comportamento dele.
Isso significa que fazer tudo certo (rate limiting, User-Agent identificável, cache local para não repetir requisição) não é suficiente se a infraestrutura de rede já está na lista negra antes da primeira requisição sair.
Por que IP móvel muda o resultado
IP de operadora de celular carrega reputação que datacenter não tem: é o mesmo tipo de endereço que serve usuários reais navegando no Chrome do celular. A heurística que bloqueia datacenter simplesmente não tem motivo técnico para bloquear tráfego de operadora — bloquear isso derrubaria usuários legítimos junto.
Como estruturar scraping com proxy móvel
Algumas práticas que fazem diferença real:
- Rotação por lote, não por requisição: manter o mesmo IP por um pequeno conjunto de páginas relacionadas (ex.: todas as páginas de um mesmo produto) parece mais humano que trocar IP a cada clique.
- Respeitar rate limit mesmo com IP que não é bloqueado: só porque você pode ir mais rápido não significa que deveria — sobrecarregar servidor de terceiro é problema mesmo sem bloqueio técnico.
- Logar taxa de sucesso por IP: se um IP específico começar a falhar mais que a média, rotacione — não espere o bloqueio generalizar.
O limite ético que vale reforçar
Proxy móvel resolve bloqueio de infraestrutura, não muda o que é permitido coletar. Dados atrás de login, conteúdo protegido por direito autoral explícito, ou APIs que exigem chave paga continuam fora do escopo — usar IP diferente não muda os termos de uso do site, só evita falso positivo de detecção de bot em coleta de dado público.
Nosso caso
A API da SelfProxy foi desenhada para esse padrão de uso: você manda a URL, recebe a resposta, decide quando rotacionar. Sem SDK pesado, sem gerenciamento de sessão de proxy manual — o dispositivo real faz a requisição, você recebe o resultado.
Próximos passos
Escolha uma URL que seu scraper atual falha com frequência (não uma qualquer — a que mais dói). Rode a mesma requisição via IP móvel e compare a taxa de sucesso lado a lado. A diferença aparece rápido.